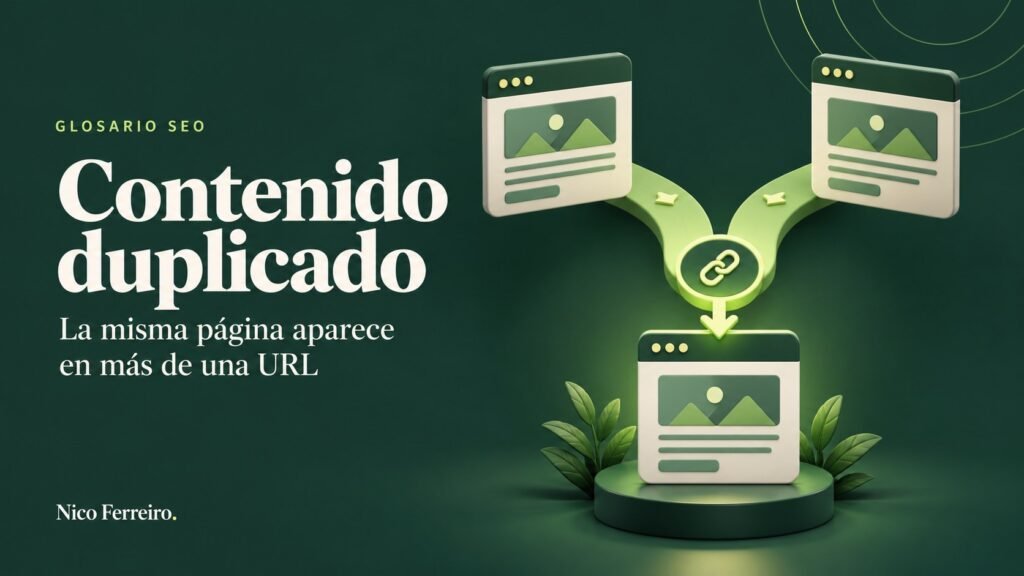
El contenido duplicado se refiere a situaciones en las que un mismo contenido, o contenido muy similar, aparece en más de una URL, ya sea dentro de un mismo sitio o entre distintos sitios web.
Inclusive también se da cuando generamos dos contenidos distintos pero que apuntan a una misma intención de búsqueda. Es decir, crear dos contenidos similares que resuelven la misma necesidad.
Desde el punto de vista de Google, el problema no es la “copia” en sí, sino la dificultad para decidir qué versión mostrar como resultado principal.
Por qué el contenido duplicado es tan común
En la práctica, el contenido duplicado rara vez es intencional. Aparece como consecuencia natural de cómo crecen los sitios.
Es especialmente frecuente en:
- eCommerce con filtros, variaciones y categorías similares
- Medios que actualizan notas sin cerrar versiones anteriores
- Sitios internacionales con traducciones mal gestionadas
- CMS que generan múltiples URLs para el mismo contenido
👉 La mayoría de los casos de contenido duplicado no vienen de malas prácticas aplicadas, sino de falta de control estructural.
Cómo lo interpreta Google (y qué NO hace)
Uno de los mitos más extendidos es que el contenido duplicado “penaliza”.
En mi experiencia, eso no es así.
Google:
- no penaliza automáticamente el contenido duplicado
- elige una versión para indexar y mostrar
- ignora o de-prioriza el resto
El problema real aparece cuando:
- Google elige la URL incorrecta
- se desperdicia autoridad
- se diluye el potencial de posicionamiento
El error más común al abordar contenido duplicado
El error típico que veo en auditorías es este:
Tratar todo contenido duplicado como un problema crítico.
Cerrar URLs, bloquear masivamente o aplicar canonical sin criterio suele generar:
- pérdida de tráfico long tail
- problemas de indexación
- fricción con equipos de negocio
No todo contenido duplicado es dañino.
El problema aparece cuando no controlás cuál versión representa mejor la intención del usuario.
Cómo trabajo el contenido duplicado en proyectos reales
En lugar de “eliminar duplicados”, el enfoque que mejor funciona es:
- Identificar la intención principal
- Definir una URL canónica real
- Asegurar coherencia técnica y editorial
- Usar canonical, enlaces internos y arquitectura, no solo reglas automáticas
En sitios grandes, el contenido duplicado nunca desaparece del todo.
El objetivo no es eliminarlo, sino gestionarlo correctamente.
De todos modos, antes de definir el enfoque, se debe analizar la situación real actual de cara al contenido duplicado.
Contenido duplicado y negocio: la variable olvidada
En mis casi 10 años de experiencia ya vi casos donde:
- varias URLs similares captaban tráfico distinto
- cada una convertía en contextos diferentes
- “arreglar” el duplicado empeoró resultados
Por eso, antes de actuar, la pregunta clave es:
¿Este contenido duplicado está afectando visibilidad o resultados de negocio?
SEO sin esa pregunta suele romper más de lo que arregla.
En resumen
- El contenido duplicado no es una penalización automática
- Es un problema de selección y control, no de castigo
- Eliminar contenido sin criterio puede ser peor que dejarlo
- La clave está en intención, arquitectura y contexto de negocio
SEO especializado en eCommerce e impacto de la IA en los comportamientos de búsqueda y compra de los usuarios. Lideré la estrategia SEO de marcas como Disney (LAT y BRA), National Geographic, Tommy Hilfiger, Calvin Klein, CACE (Cyber Monday + Hot Sale), Bimbo LATAM, Stanley Argentina entre muchas otras. Hoy trabajo en la visibilidad orgánica de Personal, con foco en el eCommerce (Tienda Personal) y en su fintech (Personal Pay). Founder de MetrIQon, co-host del podcast “El SEO Ha Muerto?” y profesor SEO en CoderHouse y UTN.